Allarmi e automazione
Gli eventi diventano comunicazioni tempestive, responsabilità definite e possibili azioni correttive.
Il canale giusto, con il contesto tecnico necessario
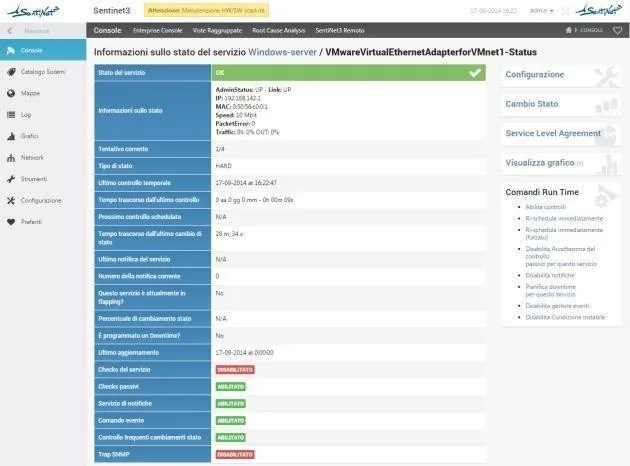
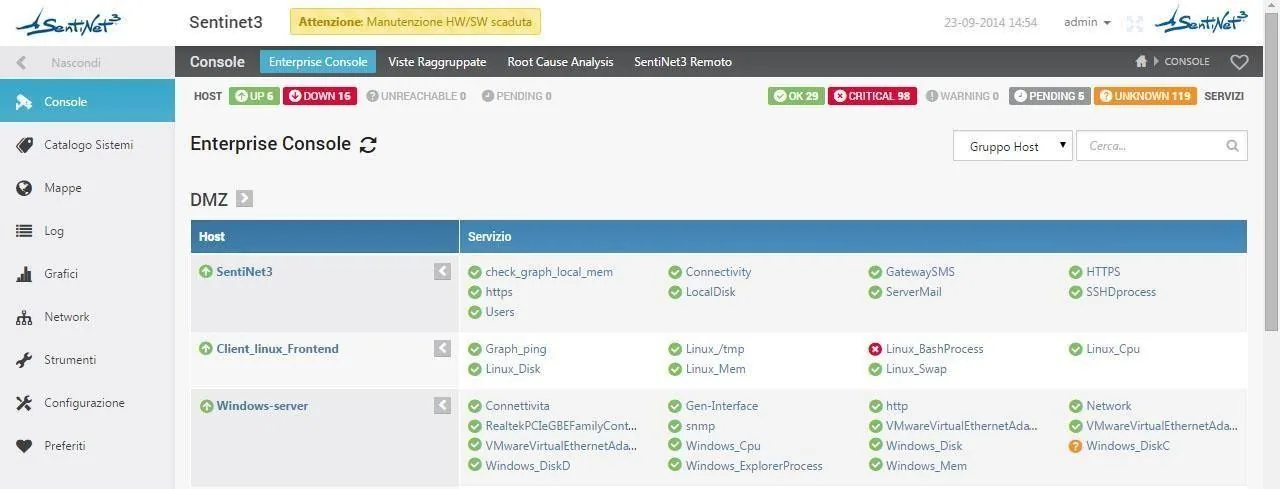
Quando una metrica supera una soglia o un servizio cambia stato, il Core attiva le notifiche e trasmette il contesto tecnico utile alla diagnosi. Il canale viene scelto in funzione del tipo di evento e della configurazione operativa.
- Notifiche personalizzabili per contenuto, formato e frequenza
- Associate a soglie statiche o dinamiche, incluse quelle calcolate dal Behavioural Learning Engine
- Distribuite per ruoli, gruppi o responsabilità individuali, con invio selettivo in base a orari, turni e calendario operativo
Messaggi con template personalizzabili, che riportano il contesto tecnico dell’evento.
SMS e notifiche push
Segnalazioni immediate sui dispositivi mobili del personale reperibile.
Messaggistica istantanea
Integrazione con Telegram, Microsoft Teams e Slack, per raggiungere i team nei loro canali di lavoro.
Chiamate vocali
Notifiche a voce per gli allarmi critici che richiedono una presa in carico immediata.
Suonerie in console
Segnalazione acustica in console nei casi di allarme critico, per la sala operativa.
Trap SNMP e Post HTTP
Canali aggiuntivi disponibili negli scenari di monitoraggio ambientale.
Ogni allarme alla persona di turno
Il calendario operativo definisce fasce orarie personalizzate per ciascun utente, team o sede e distribuisce gli allarmi in base ai turni di reperibilità. I calendari di servizio si visualizzano e si gestiscono direttamente dall’interfaccia web.
Regole condizionali stabiliscono il routing degli allarmi, per esempio:
- se l’evento si verifica di notte, viene notificato il reperibile;
- se è un giorno festivo, viene notificato un secondo livello di escalation.
Nessun allarme dipende da un solo operatore
I contatti possono essere organizzati in gruppi e gerarchie. Se l’evento non viene gestito entro l’intervallo definito, il sistema trasferisce automaticamente la segnalazione al livello successivo.
- L’evento raggiunge il gruppo di reperibilità competente.
- La criticità persiste o non viene presa in carico entro l’intervallo previsto.
- La segnalazione passa al livello successivo della gerarchia.
Meno messaggi, stessa informazione
Il meccanismo antiflood limita le notifiche ridondanti quando un evento si ripete in breve tempo: stabilisce un numero massimo di notifiche per evento in una finestra temporale, consolida gli allarmi ricorrenti in un singolo evento aggregato e applica logiche di deduplicazione e correlazione temporale.
Gli allarmi sono classificati per livello di severità, così che ogni evento riceva l’attenzione che merita.
- Distinzione tra warning, criticità ed emergenze
- Escalation automatica degli eventi ignorati o non gestiti entro intervalli definiti
- Regole di silenziamento (maintenance mode) per eventi attesi o in corso di manutenzione
Durante un guasto esteso si preserva il contenuto informativo senza moltiplicare inutilmente i messaggi.
Dalla segnalazione all’azione correttiva
Al verificarsi di specifici eventi o al superamento delle soglie, la piattaforma attiva automaticamente azioni predefinite. Le azioni sono:
- configurabili per singolo evento o per gruppo di eventi;
- condizionate da orari, stati del sistema, severità ed esiti di verifiche precedenti;
- registrate nell’audit log, per tracciabilità e conformità.
Azioni progettate con cura. Le azioni devono essere autorizzate e progettate tenendo conto della reversibilità, delle dipendenze e della continuità dei servizi.
| Azione | Cosa fa |
|---|---|
| Comandi e script remoti | Esecuzione di comandi o script via SSH, API, PowerShell e altri canali. |
| Riavvio | Riavvio di servizi o sistemi monitorati. |
| Isolamento | Isolamento di componenti di rete o di singole interfacce. |
| Mitigazione | Attivazione di un dispositivo di mitigazione o di una procedura di manutenzione. |
| Risposta automatica esterna | Integrazione con sistemi esterni di risposta automatica, orchestratori e piattaforme SOAR. |
| Ticketing | Generazione automatica di ticket o segnalazioni sui sistemi ITSM. |
Ogni notifica, evento e azione resta nel registro
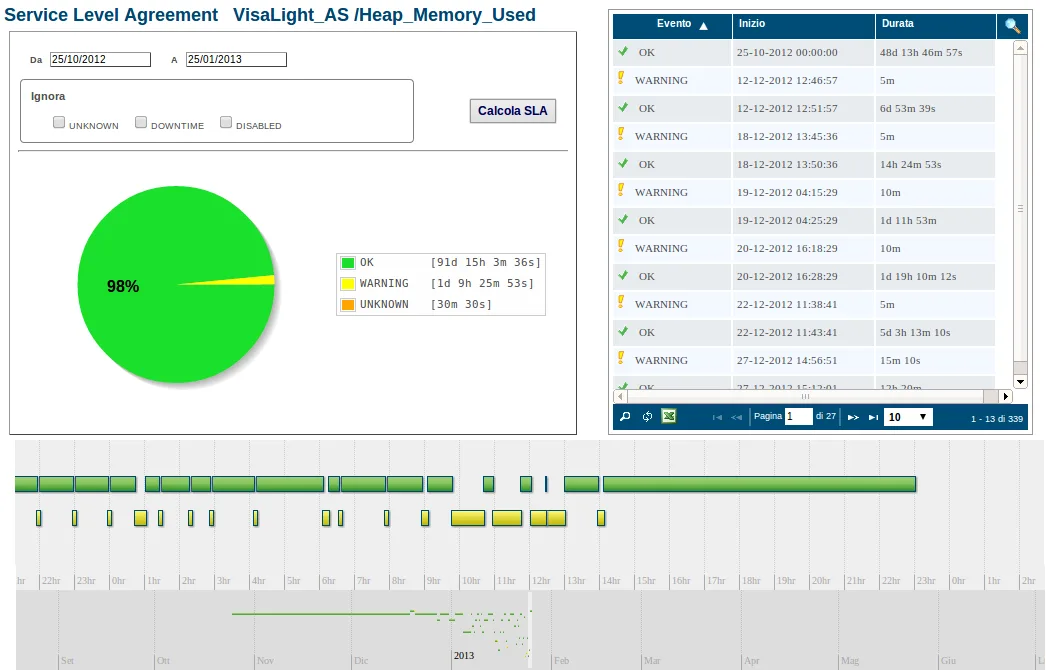
Notifiche, eventi e azioni sono tracciati automaticamente e archiviati in un registro di audit consultabile, nel quale si ricercano e si analizzano gli allarmi storici. Le registrazioni comprendono anche cambi di stato, trap SNMP, accessi e log di sistema.
Le informazioni possono essere esportate nei formati messi a disposizione dalla piattaforma per successive elaborazioni o esigenze di reporting, ad esempio insieme ai report SLA.
| Informazione registrata | Contenuto |
|---|---|
| Data e ora | Il momento in cui l’evento si è verificato e la notifica è stata inviata. |
| Origine | L’host, il servizio o il controllo che ha generato l’allarme. |
| Destinatari | Utenti, gruppi e canali a cui la notifica è stata indirizzata. |
| Stato di invio | L’esito della trasmissione della notifica. |
| Risposta eseguita | L’azione automatica o manuale intrapresa a fronte dell’evento. |
| Esiti e correlazioni | Il risultato della risposta e il legame con altri eventi correlati. |
Saturazione progressiva di un servizio
Un servizio di posta continua a rispondere, ma lo spazio libero sul disco diminuisce con regolarità. Il Core rileva il superamento delle soglie, invia una notifica ai responsabili e può attivare una procedura automatizzata di mitigazione preventivamente autorizzata. L’operatore consulta storico e grafici per stabilire l’urgenza e prevenire un’interruzione.
Tutti gli scenariApprofondimenti correlati
Vuoi vedere Sentinet³ sulla tua infrastruttura?
Raccontaci il tuo contesto: sedi, tecnologie, servizi critici. Ti mostriamo come Core e Infinity possono lavorare sul tuo caso.