Behavioural Learning e Root Cause Analysis
Leggere l’andamento delle metriche, proporre soglie più aderenti e correlare gli eventi per risalire alla causa dei guasti.
Soglie che seguono il comportamento reale dell’infrastruttura
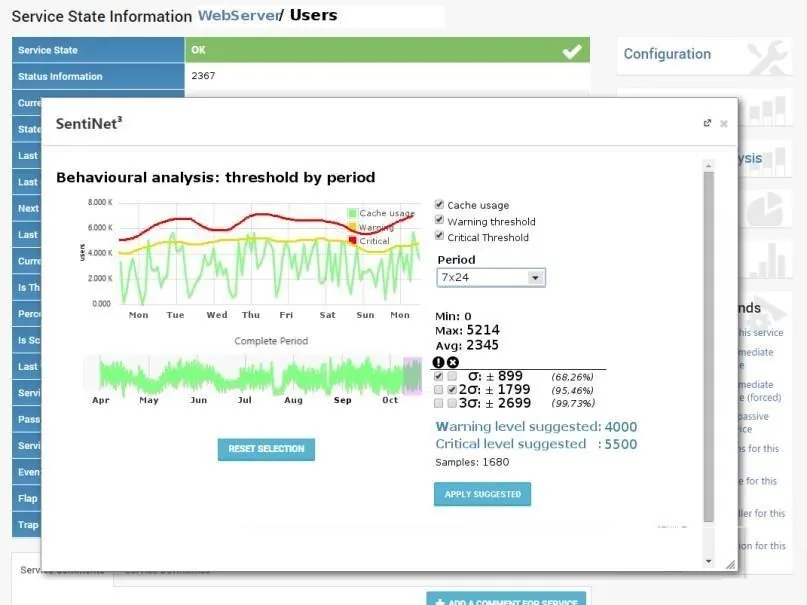
Il Behavioural Learning Engine studia i dati di monitoraggio e supporta gli operatori con suggerimenti sulle soglie da applicare ai controlli.
L’osservazione degli andamenti aiuta a distinguere condizioni ricorrenti da anomalie e a riconoscere host o servizi che mantengono configurazioni di monitoraggio non più aderenti all’infrastruttura. Mettendo in relazione gli eventi, il motore offre tre capacità:
- Behavioral Thresholding: soglie dei controlli suggerite dal comportamento reale delle metriche
- Dependency Model detection: individuazione delle dipendenze fra i componenti
- Trend Prediction: previsione dell’andamento delle metriche
Baseline adattive
Il motore apprende il comportamento normale di sistemi, applicazioni e dispositivi dai dati storici e costruisce baseline dinamiche che tengono conto di orari, giorni della settimana, stagionalità, carichi tipici e contesti operativi.
Soglie adattive
Le soglie di allarme si adattano automaticamente al comportamento appreso, riducendo i falsi positivi negli ambienti dinamici e complessi.
Anomalie senza soglie statiche
Gli scostamenti dal comportamento previsto emergono anche in assenza di soglie predefinite, inclusi eventi anomali non ancora formalmente classificati.
Automatico e supervisionato
Il motore lavora in modalità completamente automatica, con la possibilità per gli operatori di intervenire e supervisionare i casi specifici.
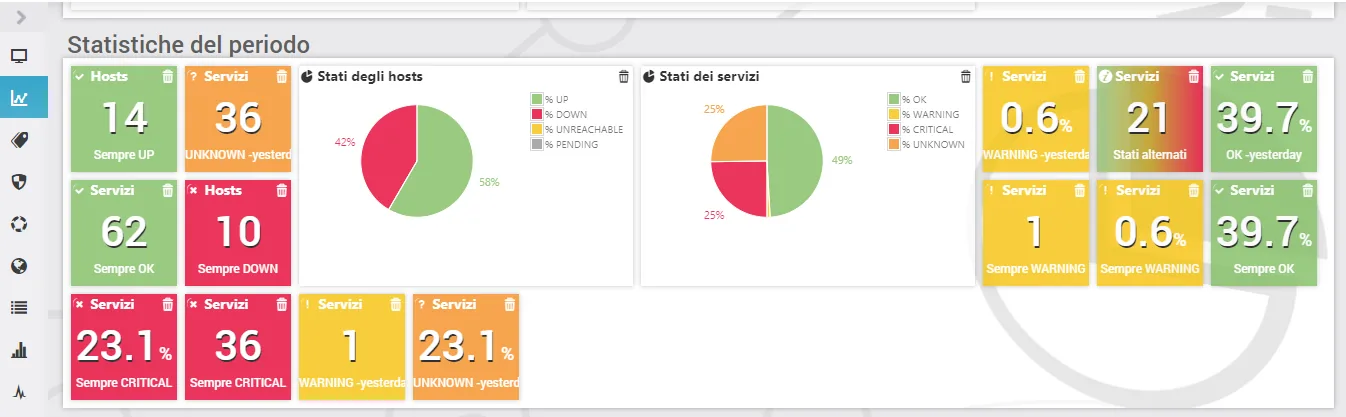
Dall’osservazione puntuale agli indicatori di insieme
La capacità di aggregare i risultati consente una lettura dell’intero ambiente o dei suoi sottoinsiemi. Le informazioni alimentano viste statistiche e Situation Analysis, mantenendo il legame fra l’osservazione puntuale delle metriche e gli indicatori complessivi.
Correlare gli eventi per trovare la causa alla radice
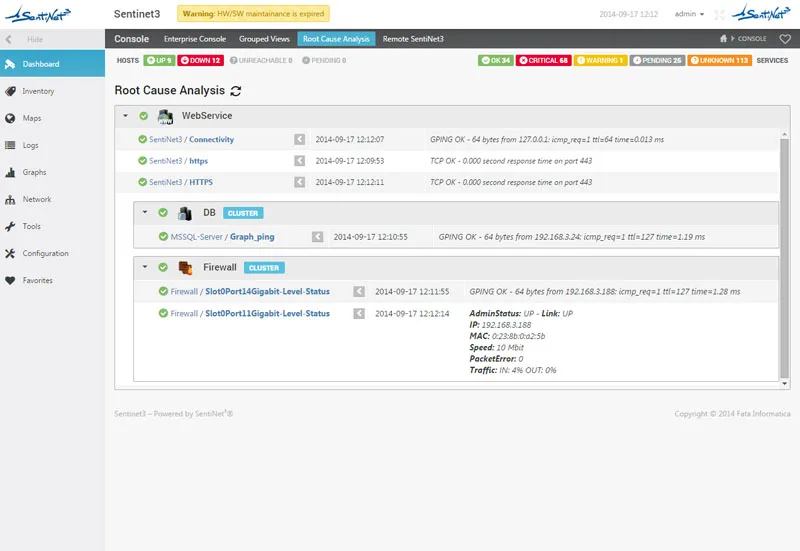
La Root Cause Analysis di Sentinet³ è un motore di correlazione degli eventi: regole basate sugli operatori AND e OR mettono in relazione più eventi e generano alert ed eventi proattivi. La causa alla radice individuata dal correlatore si consulta nella console di Root Cause Analysis.
Il motore correla eventi provenienti da fonti eterogenee (rete, host, applicazioni, sicurezza e ambiente) e identifica le relazioni causa-effetto tra allarmi attivi, metriche degradate e variazioni comportamentali. Rileva in tempo reale la causa primaria di una disfunzione, distinguendola dagli effetti secondari e dai sintomi: la rappresentazione visuale delle dipendenze riduce i tempi medi di diagnosi (MTTD) e di risoluzione (MTTR).
La diagnosi non si limita al numero di alert generati: un apparato comune a più servizi può spiegare diversi allarmi contemporanei, mentre la vista gerarchica aiuta a distinguere i sintomi dall’origine del disservizio.
- Più eventi compaiono nello stesso intervallo.
- Le regole AND/OR li correlano con stati e relazioni fra sistemi.
- La correlazione genera un alert o un evento proattivo e mette in evidenza l’elemento comune, per esempio un apparato da cui dipendono più servizi.
- Nella console di Root Cause Analysis il troubleshooting si concentra sui sistemi responsabili.
La causa alla radice di un servizio applicativo
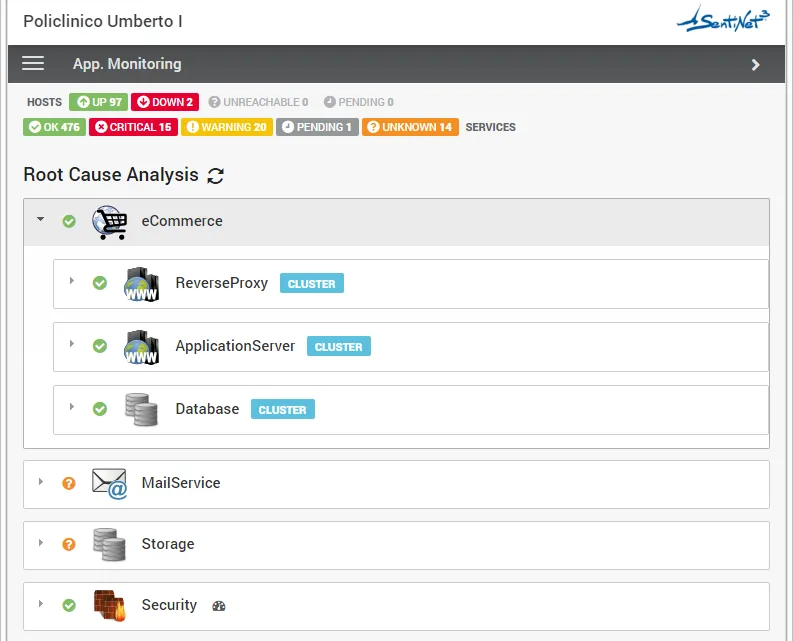
La stessa analisi si applica ai servizi composti da più componenti: per un servizio di eCommerce la console mostra lo stato di reverse proxy, application server, database, servizio di posta, storage e sicurezza, per capire quale componente ha originato il problema.
Due funzioni complementari nella gestione quotidiana
Behavioural Learning
Aiuta a configurare controlli più utili e stabili.
Correlazione e Root Cause Analysis
Correla gli eventi e concentra il troubleshooting sui sistemi responsabili.
Il giudizio resta all’operatore. In entrambi i casi la valutazione finale resta contestuale all’infrastruttura e alle informazioni disponibili.
Guasto di connettività multisede
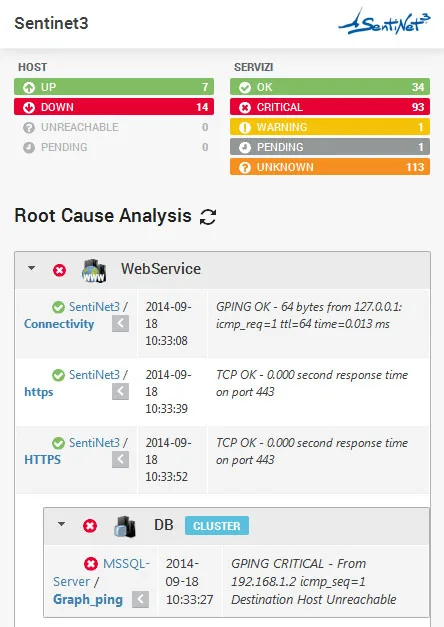
Diversi servizi di una sede risultano indisponibili nello stesso intervallo. La vista topologica, i controlli sulle interfacce e le mappe georeferenziate aiutano a distinguere il guasto di un apparato comune dalle indisponibilità dei singoli sistemi.
Tutti gli scenariApprofondimenti correlati
Vuoi vedere Sentinet³ sulla tua infrastruttura?
Raccontaci il tuo contesto: sedi, tecnologie, servizi critici. Ti mostriamo come Core e Infinity possono lavorare sul tuo caso.