Infrastruttura e sistemi
Controllo continuativo della disponibilità, dello stato e delle prestazioni delle risorse di elaborazione.
Ogni host, con il protocollo adatto
Il Core monitora host Windows, Linux e diverse piattaforme Unix ed enterprise, inclusi Solaris, HP-UX, AIX e AS/400. I controlli riguardano CPU, memoria, swap, carico di sistema, spazio e attività dei dischi, processi, servizi di sistema, disponibilità e parametri hardware esposti dagli apparati.
L’uso di protocolli diversi consente di adattare la verifica alla tecnologia controllata.
- CPU
- Memoria e swap
- Carico
- Dischi
- Processi
- Servizi di sistema
Dall’hardware ai servizi che ne dipendono
Hardware e apparati fisici
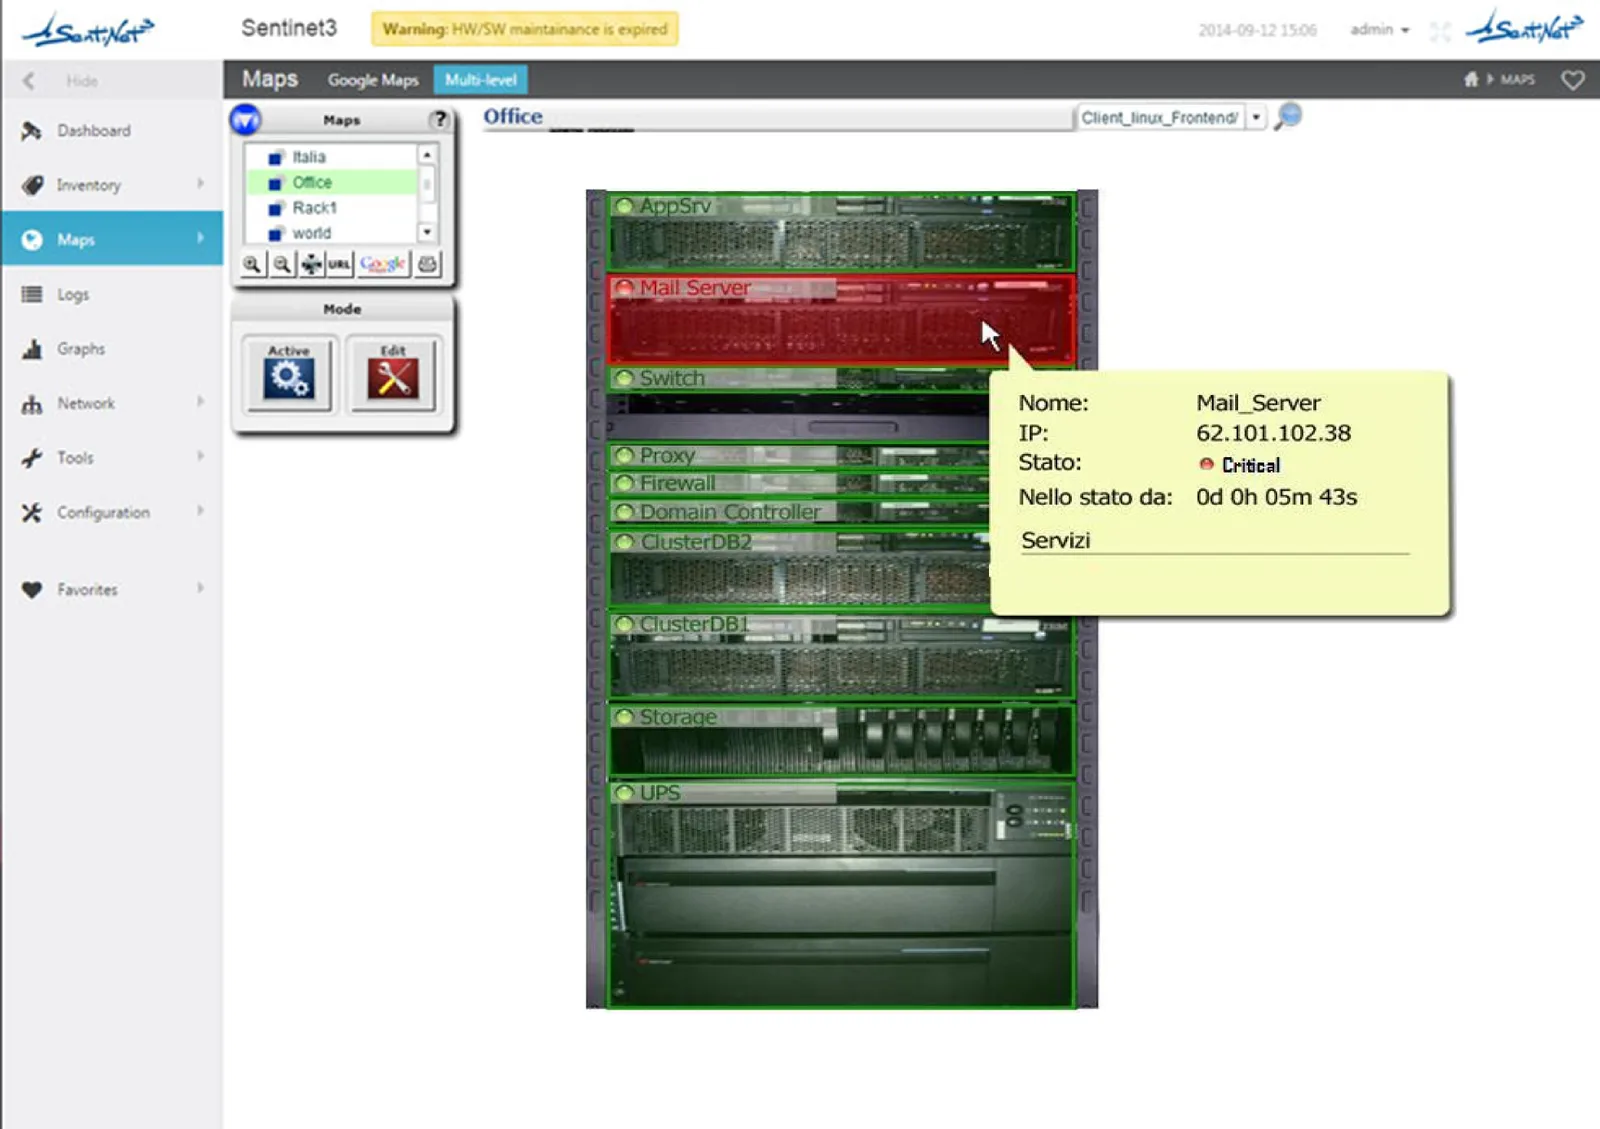
Stato dei server fisici e dei dischi, con controller RAID e SMART, e dei parametri critici: temperature, ventole, alimentatori e sensori.
Storage e SAN
Apparati di storage e reti SAN: connettività in fibra, latenza dei dischi, throughput e IOPS.
Virtualizzazione
Hypervisor VMware, KVM, Xen e Hyper-V con visibilità su host e guest: risorse allocate, utilizzo di CPU, RAM e storage, stato delle VM, per singola macchina o in viste riepilogative.
Container
Ambienti containerizzati Docker e LXC, supportati nativamente dal monitoraggio cross-platform del Core.
UPS e impianti elettrici
Parametri di alimentazione, stato di carica e scarica e allarmi su batterie, cortocircuiti e interruzioni.
Servizi essenziali
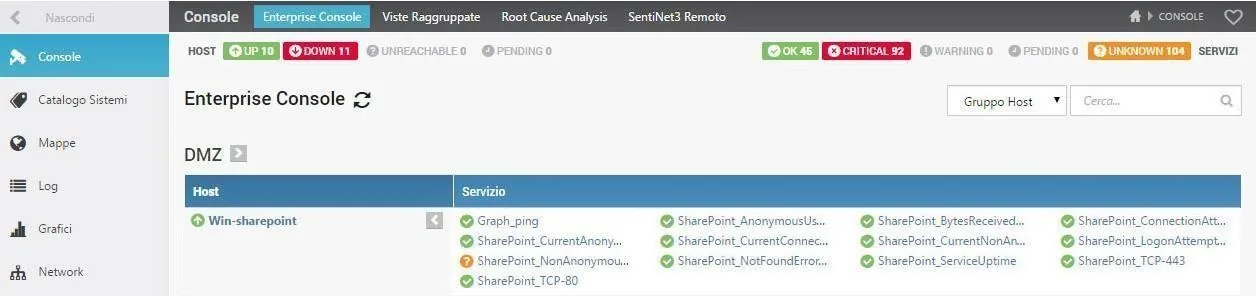
Active Directory e servizi infrastrutturali DNS, DHCP, SMTP, RADIUS, NTP e altri servizi rilevanti per la continuità operativa.
Sistema e servizio insieme. Una variazione dello stato può essere associata sia al sistema che la ospita sia al servizio che ne dipende.
Distinguere un guasto improvviso da un degrado progressivo
L’analisi dello storico, dei grafici e delle soglie consente di separare le indisponibilità improvvise dai degradi progressivi. Una crescita del consumo di memoria, un disco prossimo alla saturazione o una perdita di risposta di un servizio diventano evidenze consultabili e gestibili prima che il problema provochi un’interruzione prolungata.
Per soglie più aderenti all’andamento reale delle metriche, il Behavioural Learning Engine suggerisce i valori da applicare ai controlli.
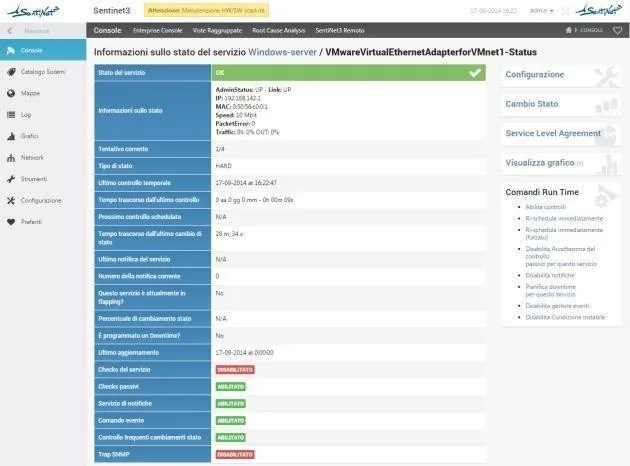
Tecnologie con Pattern dedicato
Per ognuna, il Pattern di controlli preconfigurati e l’elenco completo dei parametri.
Virtualizzazione
Tecnologie Microsoft
Ambiente
Saturazione progressiva di un servizio
Un servizio di posta continua a rispondere, ma lo spazio libero sul disco diminuisce con regolarità. Il Core rileva il superamento delle soglie, invia una notifica ai responsabili e può attivare una procedura automatizzata di mitigazione preventivamente autorizzata. L’operatore consulta storico e grafici per stabilire l’urgenza e prevenire un’interruzione.
Tutti gli scenariApprofondimenti correlati
Vuoi vedere Sentinet³ sulla tua infrastruttura?
Raccontaci il tuo contesto: sedi, tecnologie, servizi critici. Ti mostriamo come Core e Infinity possono lavorare sul tuo caso.